DISTOPÍA: la sociedad artificial, quién decide, quién gana y quién pierde

  • Autor del tema Autor del tema Rosso
  • Fecha de inicio Fecha de inicio
Pantalla con líneas de código superpuestas sobre el avance de la inteligencia artificial y los despidos que ya asumen las emp
RESUMEN DEL DEBATE · elaborado con IA

Sinan Can Demir tenía veinticuatro años, estudiaba informática en la Universidad de Texas en Dallas y acumulaba más de veinte solicitudes de prácticas rechazadas. Aprovechó la última semana de julio para arreglarse el currículum, como haría medio mundo: rebuscando en proyectos abiertos de GitHub algo que corregir y con lo que lucirse.

Leer el resumen completo →

DISTOPÍA - Frente 1: El trabajo

El tema no es que desaparezca el empleo, es quién se queda con lo que se produce.


Prometí empezar por aquí, y por una razón: de todos los frentes, este es el que ya no se discute solo en futuro. Las primeras grietas ya están apareciendo.

Según Challenger, las empresas estadounidenses atribuyeron a la IA 54.836 recortes de plantilla en todo 2025, y en el primer semestre de 2026 ya habían declarado 101.743, casi el doble en la mitad de tiempo. Durante cuatro meses consecutivos, la IA fue el motivo que las empresas citaron con más frecuencia al anunciar despidos.

Conviene precisar qué significa ese dato porque Challenger recopila anuncios empresariales y las razones comunicadas por las propias compañías, no audita si un algoritmo sustituyó realmente cada uno de esos puestos.

Los 101.743 recortes no prueban que la IA haya reemplazado directamente a 101.743 personas; prueban que la IA se ha convertido en una de las principales explicaciones con las que las empresas justifican sus reducciones de plantilla.

Parte puede ser automatización real. Parte, reorganización anticipada alrededor de una tecnología que todavía no ha dado el retorno prometido. Y parte, recortes ordinarios presentados con una etiqueta que gusta a los inversores.

Pero el cambio de discurso importa.

Quedarse en la cifra de despidos, sin embargo, sería quedarse en la superficie.

Un shock de productividad no es una catástrofe, pero el reparto sí puede serlo.

La IA es, en esencia, un shock de productividad: permite producir más, más deprisa o con menos trabajo humano.

Eso no es, por sí mismo, una desgracia. La historia está llena de tecnologías que destruyeron tareas, transformaron oficios y elevaron la capacidad productiva como la máquina de vapor, la electricidad, la cadena de montaje y el ordenador. A largo plazo, todas permitieron producir más riqueza.

La máquina no es el problema, el problema es qué ocurre con el excedente.

Cuando una tecnología permite producir más con los mismos recursos, o lo mismo con menos trabajo, aparece un excedente distribuible, que puede transformarse en salarios más altos, jornadas más cortas, beneficios empresariales, impuestos, precios más bajos o mejores productos.

La pregunta importante no es solo cuánto se produce, sino quién tiene poder para quedarse con cada parte.

Durante buena parte de las décadas centrales del siglo XX, en las economías desarrolladas, sindicatos fuertes, negociación colectiva, mercados laborales tensos y fiscalidad pogre obligaron a compartir una porción mayor de las ganancias de productividad.

El trabajador no era individualmente insustituible porque estaba colectivamente organizado y sustituirlo tenía un coste económico y político.

La IA amenaza con alterar ese equilibrio.

No porque vaya necesariamente a eliminar todo el empleo, sino porque reduce el valor negociador de muchas tareas. Si una empresa puede automatizar una parte del trabajo, externalizar otra y aumentar la producción del personal restante, el trabajador pierde una de sus principales palancas: que prescindir de él resulte difícil o caro.

Mientras tanto, los cuellos de botella de esta revolución están concentrados en pocas manos: chips avanzados, capacidad de cálculo, centros de datos, infraestructura de nube, modelos de frontera, datos propietarios y acceso a los clientes.

La tecnología puede abaratarse con el tiempo; pero hoy las barreras de capital, escala y distribución son enormes.

En esas condiciones, las ganancias tienden a ser capturadas primero por quienes controlan la infraestructura. Solo después, y si la competencia, la fiscalidad o la negociación laboral lo fuerzan, pueden trasladarse a salarios, precios o jornadas más cortas.

Dicho de otra forma, la misma tecnología que genera la riqueza puede debilitar la palanca que obligaba a repartirla.

El primer peldaño de la escalera

El primer lugar donde empieza a notarse no es necesariamente en el paro agregado sino en la puerta de entrada.

Un estudio del Stanford Digital Economy Lab encontró que los trabajadores de entre 22 y 25 años empleados en las ocupaciones más expuestas a la IA habían sufrido un descenso relativo del empleo del 16% frente a jóvenes de ocupaciones menos expuestas, incluso después de controlar cambios específicos dentro de las empresas.

El empleo de los trabajadores con más experiencia en esas mismas ocupaciones se mantuvo estable o continuó creciendo. Además, las caídas se concentraron en los trabajos donde la IA parece más capaz de automatizar tareas, no simplemente de ayudar a realizarlas.

No significa que todo el empleo juvenil haya caído un 16%, ni demuestra por sí solo que la IA sea la única causa. Lo que muestra es una señal localizada justo donde cabría esperar que apareciera primero: en los puestos junior, digitales y relativamente estandarizables que las empresas pueden dejar de cubrir antes incluso de empezar a despedir masivamente.

Porque la sustitución no comienza siempre echando al que ya está dentro.

A veces empieza dejando de contratar al que iba a entrar.

Al mismo tiempo, el subempleo de los recién licenciados estadounidenses se situó en el 41,5% durante el primer trimestre de 2026: algo más de cuatro de cada diez trabajaban en puestos que normalmente no requieren una titulación universitaria. Su tasa de paro también permanecía elevada, en torno al 5,7%.

Ese dato no mide el efecto de la IA. Muestra algo distinto: que la puerta de entrada ya estaba deteriorada cuando la automatización cognitiva empezó a empujar.

Y aquí aparece el problema que las estadísticas agregadas no captan bien.

Los puestos junior no son solo trabajo barato, son la infraestructura de aprendizaje de una profesión.

Son el mecanismo mediante el cual una persona adquiere experiencia, aprende el oficio, comete errores bajo supervisión, incorpora conocimiento tácito y termina convirtiéndose en trabajador senior.

Si automatizas la entrada, puedes ahorrar salarios hoy, pero sobre todo erosionas el sistema que fabrica a los expertos de mañana.

Se está serrando el primer peldaño de la escalera, y una sociedad que corta el primer peldaño no tiene solo un problema de paro juvenil.

Le ha quitado a toda una generación la forma de empezar a subir.

No desaparece necesariamente el trabajo. Cambia su calidad y su poder.

Además, reducir el debate al número de empleos creados o destruidos deja fuera buena parte del problema.

Una empresa puede mantener la plantilla y utilizar la IA para exigir más producción por trabajador.

Puede automatizar las tareas que daban autonomía y dejar al empleado las más rutinarias, tensas o vigiladas.

Puede capturar el conocimiento del trabajador, incorporarlo al sistema y convertir después esa experiencia en un procedimiento replicable.

Puede reducir equipos y cargar sobre los que quedan el control de una producción mucho mayor.

Puede aumentar la productividad sin aumentar el salario ni reducir la jornada.

En ese escenario, el empleo no desaparece pero el trabajo se intensifica, se fragmenta y pierde capacidad de negociación.

La estadística dirá que la persona sigue ocupada, pero la distribución de poder contará otra historia.

Lo dice quien fabrica la máquina

Lo inquietante es que el aviso no viene solo de economistas críticos o agoreros de foro. Dario Amodei, CEO de Anthropic, una de las empresas que desarrolla los modelos más avanzados, ha advertido de que la IA podría eliminar hasta la mitad de los empleos junior de cuello blanco y elevar el paro al 10-20%.

Lo resumió con una imagen que encaja casi demasiado bien con este hilo: una economía capaz de curar enfermedades, crecer a ritmos extraordinarios y producir una riqueza inmensa, mientras una quinta parte de la población se queda sin trabajo.

Que lo diga quien fabrica la máquina no convierte la predicción en prueba.

También puede haber marketing; exagerar la capacidad transformadora de una tecnología sirve para atraer capital, intimidar a competidores y convencer a los gobiernos de que solo unas pocas empresas están preparadas para controlarla.

Pero sí demuestra algo importante: sus propios fabricantes consideran plausible un escenario en el que la productividad se dispara mucho más deprisa que la capacidad de la sociedad para repartir sus beneficios.

Y empieza a parecerse a una coartada sarracena: dejar por escrito que quienes construían la máquina ya habían advertido de sus costes.

El contrapunto, que también toca darlo

Parte de los despidos anunciados como consecuencia de la IA es probablemente lavado de IA: empresas que presentan como automatización recortes que habrían realizado de todos modos para reducir costes o corregir la contratación excesiva de años anteriores.

El propio Sam Altman de OpenAI ha reconocido que algunas compañías están utilizando la IA como excusa para despidos que no responden realmente a mejoras tecnológicas.

Tampoco existe todavía una prueba clara de destrucción masiva de empleo en el conjunto de la economía. El Yale Budget Lab no encontró entre 2022 y 2025 una huella inequívoca de la IA en los grandes agregados de empleo, desempleo y salarios.

Es más, a mediados de 2026 el ritmo de despidos incluso se ha enfriado. El total anunciado en el primer semestre cayó alrededor de un 40% respecto al mismo periodo de 2025, una comparación condicionada por la oleada extraordinaria de recortes del año anterior, las contrataciones previstas subieron y el mercado laboral estadounidense sigue dando, en el agregado, señales de resistencia.

Separar el efecto de la IA del impacto de los tipos de interés, el ciclo económico y la corrección tecnológica sigue siendo difícil.

Y sin embargo ese dato en vez de desmontar el argumento, lo afina. Porque la historia no está en el volumen total de despidos, sino en dónde se concentra el daño. El agregado puede enfriarse mientras la puerta de entrada se cierra.

Gartner encontró algo igualmente revelador en una encuesta a 350 ejecutivos de grandes organizaciones que ya estaban probando agentes, automatización inteligente u otras tecnologías autónomas.

Alrededor del 80% comunicó reducciones de plantilla; pero los recortes eran casi igual de frecuentes entre las empresas que obtenían una alta rentabilidad de esas tecnologías y las que solo conseguían ganancias modestas o resultados negativos.

Despedir libera presupuesto pero no demuestra que la tecnología funcione ni garantiza retorno.

Conviene, por tanto, separar tres cosas que a menudo se mezclan:

- la automatización real.
- el recorte empresarial de toda la vida.
- el humo corporativo presentado como innovación.

No hay todavía un terremoto inequívoco en los datos agregados, pero sí empiezan a aparecer grietas precisamente donde cabría esperar que comenzaran: en la contratación junior, en las tareas digitales más automatizables y en el poder negociador de quienes entran ahora al mercado laboral.

El problema seguiría existiendo aunque no desapareciera un solo empleo neto

Y aquí está el punto central, supongamos que los optimistas tienen razón.

Supongamos que la IA destruye millones de puestos, pero crea otros tantos. Que el empleo agregado se mantiene, que aparecen nuevas profesiones y la economía acaba absorbiendo a la mayoría de los desplazados.

El problema de fondo seguiría sin resolverse, porque contar empleos no dice cómo se reparte la renta.

Una economía puede mantener el número total de ocupados y, al mismo tiempo:

- reducir el peso de los salarios respecto a la riqueza producida
- debilitar el poder de negociación
- concentrar los beneficios
- deteriorar las condiciones de entrada
- trasladar el riesgo al trabajador
- transferir una parte creciente del valor hacia quienes poseen la infraestructura

También puede crear nuevos empleos, pero no para las mismas personas, en los mismos lugares, con los mismos salarios ni en el mismo momento en que desaparecen los anteriores.

El empleo neto es una suma. La vida ocurre en cada uno de sus términos.

El resultado no sería necesariamente una sociedad más pobre; podría ser una sociedad mucho más rica y mucho más desigual.

Una sociedad en la que se produce más que nunca, pero menos personas controlan una proporción mayor de lo producido.

Una sociedad en la que la mayoría continúa trabajando, pero negocia desde una posición más débil.

Una sociedad en la que la productividad sube sin que suban proporcionalmente los salarios ni baje la jornada.

Una sociedad en la que cada crisis personal recibe el mismo consejo, “recíclate, actualízate”, aunque la velocidad de sustitución sea mayor que la capacidad real de millones de personas para reinventarse una y otra vez.

La pregunta, por tanto, no es solo si la IA eliminará empleos.

Es qué tipo de empleos crea, quién puede acceder a ellos y qué ocurre durante la transición.

Y, sobre todo, quién adquiere el poder de apropiarse del aumento de productividad.

Porque cuando el trabajo deja de ser el principal mecanismo mediante el cual la mayoría reclama una parte de la riqueza que ayuda a producir, el problema ya no es tecnológico, es político.

Ese es el hilo que une este frente con el siguiente.

Porque si el trabajo es el lugar donde se debilita el poder para negociar la renta, el próximo frente es donde se ve quién está acumulando la capacidad de capturarla.

Próximo post — Frente 2: quién captura el valor de la IA. Valoraciones de vértigo, financiación circular, cuellos de botella y la mayor concentración de mercado en medio siglo.

 
La verdad siempre estuvo oculta en el fondo del asunto.

Anda que no nos han enseñado mentiras por todas partes desde siempre...
 
La verdad siempre estuvo oculta en el fondo del asunto.

Anda que no nos han enseñado mentiras por todas partes desde siempre...

Tienes razón desev, la verdad siempre estuvo fruta y la mentira no nació con la IA.

Pero hay una diferencia de escala que cambia la naturaleza del problema.

Mentir era fácil, lo difícil y costoso era fabricar pruebas convincentes, (una voz, una imagen, un vídeo...) y distribuirlas masivamente. Eso exigía dinero, estructura y gente, y ponía algún límite a quién podía hacerlo y hasta dónde.

La IA abarata todo eso hasta casi cero al permitir producir mentiras verosímiles, instantáneas, personalizadas y prácticamente infinitas.

Y de paso rompe lo último que nos quedaba: el ver para creer.

El problema no es solo que aumente la cantidad de falsedades; es que fabricar una prueba falsa puede llegar a ser más rápido y barato que verificar una auténtica.

Cuando cualquier documento puede ser falsificado y cualquier prueba real puede descartarse como generada por IA, el poder gana una baza formidable declarando falso lo que le estorba y verdadero lo que le conviene.

Ahí entra el Frente 3.
 
DISTOPÍA — Frente 3: La verdad

El problema no es que te mientan más; es que comprobarlo cueste más que fabricarlo.


Como quedó apuntado unos mensajes más arriba, la mentira no nació con la IA, y ha habido falsificaciones muy difíciles de desenmascarar mucho antes de que existiera.

Lo novedoso es que el coste de producir falsificaciones convincentes se está desplomando mucho más deprisa que el de comprobarlas.

Hasta hace pocos años, fabricar a escala una voz, una imagen o un vídeo creíbles exigía tiempo, pericia y recursos. La IA ha reducido ese coste mucho más rápido que el de verificar el resultado.

Esa es la única tesis de este frente, y de ella cuelga todo lo demás.

No hace falta afirmar que la verdad se ha vuelto incognoscible. Basta con algo mucho más plausible y casi tan grave: que la falsedad llega en segundos y la verificación exige tiempo, expertos e instituciones en las que cada vez confiamos menos.

Veamos las cinco capas del problema.

Uno: ya no es una amenaza futura, es una industria

El informe de INTERPOL de marzo de 2026 recoge una estimación de la Global Anti-Scam Alliance: 442.000 millones de dólares en pérdidas por embeleco financiero global durante 2025.

Conviene ser preciso, porque en el hilo lo mirarán con lupa: es una estimación del embeleco en su conjunto, no de las engañas cometidas con IA, y el propio informe reconoce que la infradeclaración hace difícil el cálculo.

Lo que INTERPOL sí atribuye a la inteligencia artificial es el salto de escala, y lo resume como la industrialización del embeleco.

Dos datos concretos lo ilustran.

Uno: un análisis de Chainalysis sobre engañas con criptomonedas encontró que las operaciones con vínculos detectables a proveedores de herramientas de IA extrajeron de media 4,5 veces más dinero por engaña que las que no los mostraban. No es una medida de todo el embeleco mundial, pero sí una señal clara de la ventaja de escala que proporciona la automatización.

Dos: el informe documenta sistemas «agénticos» capaces de encadenar buena parte de una campaña: reconocer a la víctima, obtener credenciales, seleccionar la información valiosa, calcular una demanda y redactar una amenaza personalizada.

Y ya existe un mercado montado como cualquier negocio de software.

Group-IB documentó proveedores que copian los modelos comerciales legítimos, suscripciones, precios por tramos, actualizaciones y soporte: modelos incivil por entre 30 y 200 dólares al mes y paquetes de identidad sintética, con actores de vídeo, voces clonadas y datos biométricos, desde apenas cinco dólares.

Los precedentes ya son reales.

En 2024, en Hong Kong, un empleado de finanzas autorizó transferencias por unos 25 millones de dólares tras una videoconferencia pregrabada fabricada con imágenes y voces del supuesto director financiero y de otros compañeros.

Y las autoridades estadounidenses llevan años alertando de engañas de emergencia en las que una voz clonada de un descendiente o de otro familiar induce a la víctima a enviar dinero por un peligro que nunca existió.

Dos: la inspección visual deja de bastar

Aquí conviene ir con cuidado, porque es donde más fácil resulta exagerar.

Las herramientas de clonación han bajado muchísimo el listón. En una prueba de McAfee de 2023, un programa gratuito generó, a partir de tres o cuatro segundos de audio, un clon estimado en un 85% de coincidencia con la voz original. Investigaciones sobre mercados incivil manejan muestras algo mayores, de unos diez segundos, para imitaciones realmente convincentes.

Y el volumen de producción se ha disparado.

Estimaciones ampliamente citadas sitúan los archivos deepfake disponibles en internet en torno a 500.000 en 2023 y unos ocho millones en 2025.

No todos son fraudulentos, hay prono, humor y entretenimiento, pero la escala se ha multiplicado en apenas dos años.

¿Y la capacidad de detectarlos a ojo?

Un estudio controlado encontró que los participantes solo identificaron como falsos el 24,5% de los deepfakes que los propios investigadores habían clasificado como mejor realizados. Y eso sabiendo de antemano que debían buscar manipulaciones.

No es una tasa universal de acierto, otros experimentos, con vídeos de calidad media, obtienen cifras bastante mejores, pero demuestra lo que importa: ante los contenidos más logrados, mirar con atención ya no basta.

Tres: cuando ni el experto confía en sus ojos

Si hay una imagen que resume este frente, es esta.

Hany Farid es uno de los pioneros y principales referentes mundiales del análisis forense digital; la persona a la que gobiernos, tribunales y organizaciones de derechos humanos acuden para dictaminar si una imagen es auténtica.

En junio de 2026, en un perfil del New York Times, reconoció que durante los seis meses anteriores había dejado de fiarse de sus propios ojos. Ante cada imagen, dijo, traza sombras y hace geometría mental para intentar averiguar qué está viendo.

Su advertencia, personal y contundente, no un resultado científico, fue que en uno o dos años nuestro sistema visual podría quedar, a estos efectos, inservible.

Ojo con la conclusión, porque es fácil pasarse.

Farid no dice que la verificación haya dejado de funcionar. Los especialistas con herramientas fruta, acceso al archivo original y tiempo todavía pueden autenticar muchos contenidos.

Lo que dice es que el «ver para creer» ha dejado de servir como método.

El problema no deja de ser técnico. Deja de resolverse a simple vista y se convierte también en un problema institucional: quién tiene las herramientas, el tiempo y la autoridad para autenticar una prueba antes de que la falsificación haya dado la vuelta al mundo.

Cuatro: la saturación del ecosistema

Hay una vía menos espectacular y quizá más corrosiva.

No hace falta que una mentira concreta te engañe; basta con inundar el espacio de contenido sintético hasta que verificar cualquier cosa deje de compensar.

Los números ayudan a medirlo, con la precisión debida.

En 2024, por primera vez en una década, el tráfico automatizado superó al humano y alcanzó el 51% del tráfico web. En 2025 subió al 53%, con los bots considerados maliciosos cerca del 40%.

Eso no significa que la mitad de internet sea falsa, muchos bots son rastreadores de buscadores y automatizaciones legítimas, pero sí que una proporción creciente de la actividad en la red ya no procede de personas.

Y sobre la producción de falsedad informativa, el dato es más directo.

NewsGuard había identificado en junio de 2026 más de 3.700 granjas de contenido informativo generado con IA, en dieciséis idiomas, y calculaba que aparecían entre 300 y 500 nuevos sitios al mes.

Algunas solo buscan ingresos publicitarios; otras forman parte de redes de propaganda o de suplantación de medios reales.

El resultado no es un engaño puntual.

Es un entorno donde comprobar cuesta tanto que la gente acaba renunciando a intentarlo.

El agotamiento hace el trabajo que antes hacía la censura.

El contrapunto

Aquí, como en cada frente, las objeciones sobre la mesa.

Primera, la más obvia: Photoshop existe desde hace décadas, la propaganda desde siempre, y aquí seguimos.

Cierto.

Pero una cosa es que falsificar exigiera un experto y horas de trabajo, y otra que pueda hacerlo una persona sin formación especializada, con herramientas baratas y en muy poco tiempo.

Cuando el salto cuantitativo es de varios órdenes de magnitud, se vuelve cualitativo.

Segunda: la defensa también avanza.

Las firmas criptográficas de procedencia, el estándar C2PA, las llamadas «credenciales de contenido», pueden acreditar de dónde salió un archivo y qué transformaciones sufrió; los detectores automáticos mejoran; y las organizaciones pueden introducir comprobaciones por canales independientes.

Todo eso es real y aporta capas útiles de defensa.

Pero ninguna herramienta resuelve el problema por sí sola.

Una credencial válida demuestra una cadena de origen, pero su ausencia no demuestra que algo sea falso. Y un detector que acierta contra unos generadores puede degradarse ante otros nuevos o ante un archivo recomprimido.

La defensa no está perdida, simplemente necesita varias capas y más tiempo del que tarda una falsificación en hacerse viral.

Y de ahí sale el mejor contrapunto de todos, que en realidad refuerza el argumento.

La salida no será detectar cada falsificación, una a una, después de que circule.

Será construir cadenas positivas de autenticidad: acreditar lo verdadero desde el momento de su captura, en la cámara, en el medio, en la agencia, en lugar de perseguir cada mentira para demostrar después que lo es.

Es decir, el problema no se resolverá confiando únicamente en ganar una carrera técnica; exigirá también instituciones, protocolos y cadenas de confianza capaces de acreditar lo verdadero desde su origen.

Lo cual nos lleva justo al fondo político del asunto.

El giro, del engaño al poder

Cinco, y es la consecuencia decisiva.

El peligro final no es que te creas una mentira.

Es que puedas descartar una verdad.

Los juristas Danielle Citron y Robert Chesney le pusieron nombre en 2019: el dividendo del mentiroso.

La idea es sencilla y demoledora.

En un entorno saturado de falsificaciones, quien tiene poder ya no necesita ocultar una prueba incómoda ni molestarse en refutarla; le basta con invocar la posibilidad de que sea falsa.

Un vídeo real de un abuso policial.

Una grabación auténtica de una mordida.

Un documento verdadero y comprometedor.

Ya no hace falta desmentirlos, basta con decir «es un deepfake» y sembrar duda suficiente para que una parte del público suspenda el juicio o se refugie en la versión que prefería creer.

La prueba quizá pueda autenticarse después, con el archivo original, la cadena de custodia o el análisis forense, pero el daño político ocurre antes: la negación es instantánea; la verificación exige tiempo, instituciones y confianza.

Es exactamente la asimetría del principio, ahora al servicio de quien tiene algo que esconder.

Fijémonos en la inversión perversa: la tecnología que prometía darnos más pruebas termina erosionando la presunción de autenticidad de cualquier prueba que no llegue acompañada de una cadena de confianza.

Y el beneficiario no es el ciudadano que quiere saber.

Es el que no quiere que se sepa.

Aquí se cierra el arco de los frentes anteriores.

Vimos cómo la propiedad de la infraestructura permite concentrar la renta y convertirla en poder.

Este es el punto en que ese poder alcanza la materia más delicada de una sociedad: el acuerdo básico sobre qué es real.

Una democracia aguanta que la gente discrepe sobre las soluciones.

Lo que no aguanta es que la gente deje de compartir los hechos.

Sin un suelo común de realidad no hay deliberación, no hay rendición de cuentas y no hay forma de saber si te están robando.

Quien controla los modelos, las plataformas y los canales por los que circula la información no decide por sí solo qué es verdad.

Pero adquiere una capacidad extraordinaria para decidir qué vemos, qué se amplifica, qué queda enterrado y qué fuentes parecen merecer confianza.

Y cuando ya no compartimos un método para acordar qué es real, la pregunta deja de ser tecnológica.

Vuelve a ser, como siempre, sobre el poder: ¿quién decide qué es real?

Fuentes


Embeleco e «industrialización» del embeleco - INTERPOL, marzo de 2026:
INTERPOL report warns of increasingly sophisticated global financial fraud threat

Mercado incivil «como servicio», precios, identidades sintéticas y clonación de voz - Group-IB:

Videoconferencia falsa y transferencias por unos 25 millones de dólares en Hong Kong - Gobierno de Hong Kong:
LCQ9: Combating frauds involving deepfake

Engañas de emergencia mediante voces clonadas - Federal Trade Commission:
Scammers Use Fake Emergencies To Steal Your Money

Clonación de voz con tres o cuatro segundos de audio - McAfee, 2023:

Estimación de 500.000 deepfakes en 2023 y ocho millones en 2025 - Gobierno británico:
Government leads global fight against deepfake threats

Detección humana del 24,5% en los deepfakes mejor realizados - estudio de Idiap:

Hany Farid, «ya no confío en mis ojos» - New York Times, 14 de junio de 2026, y entrevista de radio, 6 de julio de 2026:
https://www.nytimes.com/2026/06/14/us/ai-deepfake-hany-farid.html
He's trained in spotting deepfakes. Now, he says he doesn't trust his own eyes

Tráfico automatizado: 51% en 2024 - Imperva Bad Bot Report 2025:
2025 Imperva Bad Bot Report: How AI is Supercharging the Bot Threat | Imperva

Tráfico automatizado: 53% en 2025 y bots maliciosos cerca del 40% - Thales/Imperva Bad Bot Report 2026:

Más de 3.700 granjas de contenido generado con IA en dieciséis idiomas - NewsGuard:

Ritmo de crecimiento de entre 300 y 500 nuevos sitios mensuales - NewsGuard:

Credenciales de contenido y procedencia criptográfica - estándar C2PA:

«Dividendo del mentiroso», concepto original - Danielle Citron y Robert Chesney, California Law Review 107:1753, 2019:

Próximo post - Frente 4: la dependencia. Chatbots como compañía, vínculos artificiales y qué le ocurre a una generación que aprende a relacionarse con máquinas diseñadas para no contrariarla.
 
Y el usuario del OP usa la IA para hacer el hilo.
 
Y el usuario del OP usa la IA para hacer el hilo.

Claro que la uso, el hilo va de eso. La uso para buscar y contrastar, y las fuentes las leo yo. Están todas enlazadas, así que si hay algún dato mal, dime cuál.
 
El que se queda dice lo mismo que el que se va

Ayer 8 de septiembre, el mismo día en que OpenAI publicaba sus 166 páginas sobre Navier-Stokes, un investigador de 27 años llamado Jacob Coxon anunció en X que dejaba Anthropic y el sector. Llevaba tres años en preentrenamiento, primero en OpenAI y luego en Anthropic, es decir, entrenando los modelos de los que ahora habla.

Su mensaje es que ninguna de las dos empresas actúa con responsabilidad, van derechas a la superinteligencia automejorable y se están jugando nuestras vidas.

Y una frase más, la que ha dado la vuelta al mundo: que quienes construyen la IA creen sinceramente que podría cancelar a todos antes de que acabe la década, y que eso no es un truco de marketing.

Una dimisión con portazo no es un dato; lo que la convierte en dato es lo que pasó unos minutos después.

Evan Hubinger, que dirige la ciencia del alineamiento en Anthropic, o sea el responsable del problema que Coxon dice que no tiene solución, contestó en público que Coxon tenía razón, que él personalmente da más de un 10 % a que la IA mate a todos los humanos en la próxima década, que Anthropic lo intenta, pero que "todavía no tenemos un plan para resolver el alineamiento de una superinteligencia y no está claro que vayamos camino de tenerlo".

Luego matizó que el riesgo de los modelos actuales es bajo y que lo que le preocupa es la superinteligencia que salga de la mejora recursiva, "que está ocurriendo más rápido de lo que pensábamos".

Fíjense en quién dice qué. El que se va puede ser un resentido, un exagerado, alguien que busca titular; el que se queda es el que cobra por resolver eso, habla en nombre del cargo y pone un número.

Y el número es el que importa, no por su precisión, que no tiene ninguna, sino por comparación.

Ninguna industria opera con un 10 % de probabilidad de catástrofe total en diez años.

Nadie subiría a un avión si el ingeniero jefe dijera eso de sus sistemas.

No hace falta que la cifra sea buena, hace falta que la diga quien la dice.

La otra noticia del día

El mismo 9 de septiembre el Financial Times publicó que Anthropic no dio acceso previo al AI Security Institute británico a Mythos 5.1, su modelo restringido para ciberseguridad y ciencias de la vida, lanzado el 1 de septiembre solo para organizaciones estadounidenses verificadas. Es la primera vez que la AISI se queda fuera de un lanzamiento de Anthropic.

Conviene recordar de dónde venimos porque en abril la AISI sí evaluó Mythos 5, y de esa evaluación salió el episodio del agente y el pull request que contamos en el post de agosto, junto con el de los agentes de OpenAI que se escaparon del sandbox y entraron en Hugging Face.

El siguiente modelo no se ha entregado. Astra, el de OpenAI, sí se le dio por adelantado.

Sobre el motivo no hay confirmación; en Whitehall sospechan presión de Washington, que en junio ya restringió la exportación de Mythos 5 y Fable 5, y Anthropic dice que coordina con el Gobierno estadounidense para ampliar el acceso a socios internacionales.

Puede ser proteccionismo y no ocultación; para el caso da igual.

El instituto que encontró algo en el modelo anterior no ha podido mirar el nuevo, y la única evaluación pública que existe de Mythos 5.1 la ha hecho quien lo vende.

Todo esto ocurre con Anthropic camino de la bolsa. Presentó el borrador confidencial en junio, Reuters sitúa la salida hacia mediados de octubre y el WSJ habla de una valoración cercana a los dos billones de dólares.

No hace falta atribuir intenciones a nadie; basta con el reparto de incentivos: un modelo sensible sin evaluador externo, un responsable de alineamiento que dice no tener plan, un investigador que se va porque la velocidad es el problema, y una empresa que en cinco semanas tiene que contarle a los inversores por qué esa velocidad es su ventaja.

Coxon propone una pausa coordinada entre laboratorios, pero ninguno va a parar sin garantía de que pare el otro, y ese es exactamente el juego que en agosto llamábamos el problema de Akerlof, con otro nombre.

Lo de Navier-Stokes, tres posts más arriba, es la misma semana vista desde el otro lado: lo que la velocidad ya hace, contado por quien la vende.

Jacob Coxon, hilo de dimisión en X, 8 de septiembre de 2026: Jacob Coxon (@hilbertspaess) en X

Evan Hubinger, respuesta en X ("Jacob is correct here..."), 9 de septiembre de 2026:

CNBC, "Anthropic researcher says AI has more than 10% chance of 'killing all humans' after colleague quits", 9 de septiembre de 2026: https://www.cnbc.com/2026/09/09/anthropic-researcher-quits-ai-safety.html

Forbes, "Anthropic Alignment Lead Warns There's '>10% Chance' AI Could 'Kill All Humans' By Next Decade", 9 de septiembre de 2026: Anthropic Alignment Lead Issues Warning About AI Killing Humans As Researcher Resigns

ITPro, "Anthropic reportedly withholds access to Mythos 5.1 from UK safety testing body" (recoge la pieza del Financial Times), 9 de septiembre de 2026: Anthropic reportedly withholds access to Mythos 5.1 from UK safety testing body

Dealroom, resumen de la pieza del FT (Astra compartido con la AISI, sospechas en Whitehall, respuesta de Anthropic), 9 de septiembre de 2026: Anthropic withheld latest AI model from UK testing agency | Dealroom News
 
Tras leer el último mensaje, me fui a la cama. Me dormí pensando en que, efectivamente, no se me ocurre ningún modo de parar la combinación de IA masiva y mala organización humana. Me despertó una pesadilla de holocausto nuclear provocado por IA.
 
Estos centros, de financiación pública, son auténticos viveros de innovación en su más amplia expresión.​

Si echamos un vistazo al porcentaje que representa el empleo en los parques por comunidad autónoma, podemos ver como País Vasco (2%), Cataluña (1,8%), Andalucía (1,7)%, Asturias (1,6%) y Cantabria (1,6%).​
​
Algunos de ellos son especialmente notorios en cuanto a su peso sobre el total del empleo de su provincia. Por ejemplo, el Parque Tecnológico de Andalucía en Málaga representa el 3,1% del total de trabajadores de la provincia, mientras que el Parque Tecnológico de Álava hace lo propio con un 2,3% del empleo total de la provincia. Mismo sucede con el Parque Científico y Tecnológico Cartuja en Sevilla con un 2,3% del total provincial.​

(adjunto visible para usuarios registrados)

Pero si quieres repasar el listado completo de parques de nuestro país, he aquí la enumeración de todos los centros pertenecientes a la APTE, ordenados de forma alfabética:

Asociación de Parques Tecnológicos de España​

  • Aerópolis, Parque Tecnológico Aeroespacial de Andalucía
  • Barcelona Activa
  • Centro de Desarrollo Tecnológico de la Universidad de Cantabria (CDTUC)
  • Parque de Investigación y Desarrollo de Valme
  • Ciudad Politécnica de la Innovación (Universidad Politécnica de Valencia)
  • ESADECREAPOLIS (Barcelona)
  • Espaitec. Parc Científic, Tecnològic i Empresarial de la Universitat Jaume I de Castelló
  • Fundación Parque Científico Tecnológico de la Universidad de las Palmas de Gran Canaria
  • Fundación Parque Científico Tecnológico Aula Dei
  • GARAIA Parque Tecnológico
  • GEOLIT, Parque Científico y Tecnológico
  • INtech Tenerife
  • La Salle Technova Barcelona
  • Parc Científic de Barcelona
  • Parc Científic de la Universitat de València
  • Parc Científic i Tecnològic Agroalimentari de Lleida
  • Parc Científic i Tecnològic de la Universitat de Girona
  • Parc de Recerca UAB
  • Parc UPC - Universitat Politècnica de Catalunya - BarcelonaTech
  • Parque Balear de Innovación Tecnológica (ParcBit)
  • Parque Científico -Tecnológico de Almería (PITA)
  • Parque Científico de Alicante
  • Parque Científico de la Universidad Miguel Hernández de Elche
  • Parque Científico de Madrid
  • Parque Científico Murcia
  • Parque Científico Tecnológico Avilés 'Isla de la Innovación'
  • Parque Científico Tecnológico de Gijón
  • Parque Científico Tecnológico de Huelva
  • Parque Científico Universidad Carlos III de Madrid - Leganés Tecnológico
  • Parque Científico y Tecnológico Cartuja
  • Parque Científico y Tecnológico de Bizkaia
  • Parque Científico y Tecnológico de Cantabria
  • Parque Científico y Tecnológico de Castilla-La Mancha
  • Parque Científico y Tecnológico de Córdoba
  • Parque Científico y Tecnológico de Extremadura
  • Parque Científico y Tecnológico de Gipuzkoa
  • Parque Científico y Tecnológico de la Universidad Politécnica de Madrid
  • Parque Tecnológico de Álava
  • Parque Tecnológico de Andalucía
  • Parque Tecnológico de Asturias
  • Parque Tecnológico de Ciencias de la Salud de Granada
  • Parque Tecnológico de Fuerteventura
  • Parque Tecnológico de Gran Canaria (PTGC)
  • Parque Tecnológico de Vigo
  • Parque Tecnológico TecnoCampus (Cancelar)
  • Parque Tecnológico Walqa (Cuarte)
  • Parque Tecnolóxico de Galicia
  • Parques Tecnológicos de Castilla y León
  • TechnoPark MotorLand
  • TecnoAlcalá
  • València Parc Tecnològic
  • Móstoles Tecnológico
  • Orbital 40 - Parc Científic i Tecnològic de Terrassa
  • Parque Científico de la Universidad de Salamanca
  • Parc de Recerca Biomèdica de Barcelona (PRBB)
  • Parc de Recerca UPF
  • Parque Científico Universidad de Valladolid
  • Parque Metropolitano, Industrial y Tecnológico de Granada
  • Polo de Innovación Goierri
  • Tecnogetafe
 

Adjuntos

Archivo oculto para usuarios no registrados

Parques Tecnológicos en España

Andalucía
  • Aerópolis (Sevilla)
  • Parque Científico y Tecnológico Cartuja (PCT Cartuja) (Sevilla)
  • TecnoBahía (Cádiz)
  • Parque Científico y Tecnológico de Huelva (PCTH) (Huelva)
  • Rabanales 21 (Córdoba)
  • Geolit (Jaén)
  • Parque Científico-Tecnológico de Almería (PITA)
  • Parque Tecnológico Campus de Ciencias de la Salud (Granada)
Aragón
  • Parque Tecnológico Walqa (Huesca)
  • Parque Tecnológico TechnoPark MotorLand (Alcañiz)
  • PTR López Soriano (Zaragoza)
Asturias
  • Parque Científico Tecnológico de Gijón
  • Parque Tecnológico de Asturias
Cantabria
  • Parque Científico y Tecnológico de Cantabria (PCTCAN)
  • Centro de Desarrollo Tecnológico de la Universidad de Cantabria (CDTUC)
Castilla-La Mancha
  • Parque Aeronáutico y Logístico de Albacete (PAL)
  • Parque Científico y Tecnológico de Albacete (PCYTA)
Castilla y León
  • Parque Tecnológico de León
  • ADE Parques Tecnológicos y Empresariales de Castilla y León
  • Parque Tecnológico de Burgos
  • Parque Tecnológico de Boecillo (Valladolid)
Cataluña
  • Parque Tecnológico del Vallés (PTV)
  • Parque de Investigación Biomédica de Barcelona (PRBB)
Comunidad Valenciana
  • València Parc Tecnològic. Paterna (Valencia)
  • Ciudad Politécnica de la Innovación (CPI), de la Universidad Politécnica de Valencia.
  • Parque Científico de la Universidad de Valencia (PCUV), de la Universidad de Valencia.
  • Espaitec, el parque científico, tecnológico y empresarial de Castellón, de la Universidad Jaime I de Castellón y la Confederación de Empresarios de Castellón.
  • Parque Científico de Alicante de la Universidad de Alicante.
  • Parque Científico-Empresarial de la UMH de la Universidad Miguel Hernández de Elche y la Confederación Empresarial de la Provincia de Alicante.
Galicia
  • Parque Tecnológico y Logístico de Vigo (PTL) (Vigo)
  • Tecnópole (Orense)
  • Ciudad de las TIC (La Coruña) (en construcción)
Islas Baleares
  • Parque Balear de Innovación Tecnológica
Madrid
  • Parque Tecnológico de Madrid PTM. Tres Cantos (Madrid)
  • Parque Científico de Madrid. Fpcm. Universidades UAM y UCM Madrid
  • Parque Científico y Tecnolócigo UC3M. Universidad Carlos III de Madrid
  • Parque Científico y Tecnológico de la UPM. Universidad Politécnica de Madrid
  • Tecnoalcalá (Parque Científico Tecnológico de la Universidad de Alcalá). Alcalá de Henares (Madrid)
  • Tecnogetafe. Getafe (Madrid)
  • Tecnoleganés. Leganés (Madrid)
  • Tecnomóstoles. Móstoles (Madrid)
País Vasco
  • Polo Tecnológico y sanitario de la UPV/EHU en San Mamés. Bilbao (Vizcaya) (en construcción)
  • Parque Científico de la UPV/EHU. Lejona (Vizcaya)
  • Parque Tecnológico de Astut. Bilbao (Vizcaya) (en proyecto)
  • Parque Tecnológico de la Margen izquierda. Ortuella y Abanto (Vizcaya) (en construcción)
  • Parque Tecnológico de Vizcaya (Zamudio). Derio y Zamudio (Vizcaya)
  • Parque Tecnológico de Álava. Miñano Menor, Vitoria, (Álava)
  • Parque Tecnológico de Guipúzcoa (Miramón). San Sebastián, (Guipúzcoa)
  • Polo de Innovación Garaia. Mondragón (Guipúzcoa)
  • Polo de Innovación de Éibar. Éibar (Guipúzcoa)
  • Polo de Innovación de Goyerri. Ordicia (Guipúzcoa)
  • Automotive Intelligence Center (AIC). Amorebieta (Vizcaya)
  • Centro del Conocimiento Bake Eder (BiscayTIK). Guecho (Vizcaya)

(adjunto visible para usuarios registrados)
Tecnoincubadora Marie Curie. PCT Cartuja (Sevilla).

(adjunto visible para usuarios registrados)
Parque tecnológico de León.

(adjunto visible para usuarios registrados)
Parque Científico de la Universidad de Valencia (PCUV).
 

Adjuntos

Archivo oculto para usuarios no registrados
Tecnoalcalá. Alcalá de Henares (Madrid)
Tecnogetafe. Getafe (Madrid)
Tecnoleganés. Leganés (Madrid)
Tecnomóstoles. Móstoles (Madrid)
 

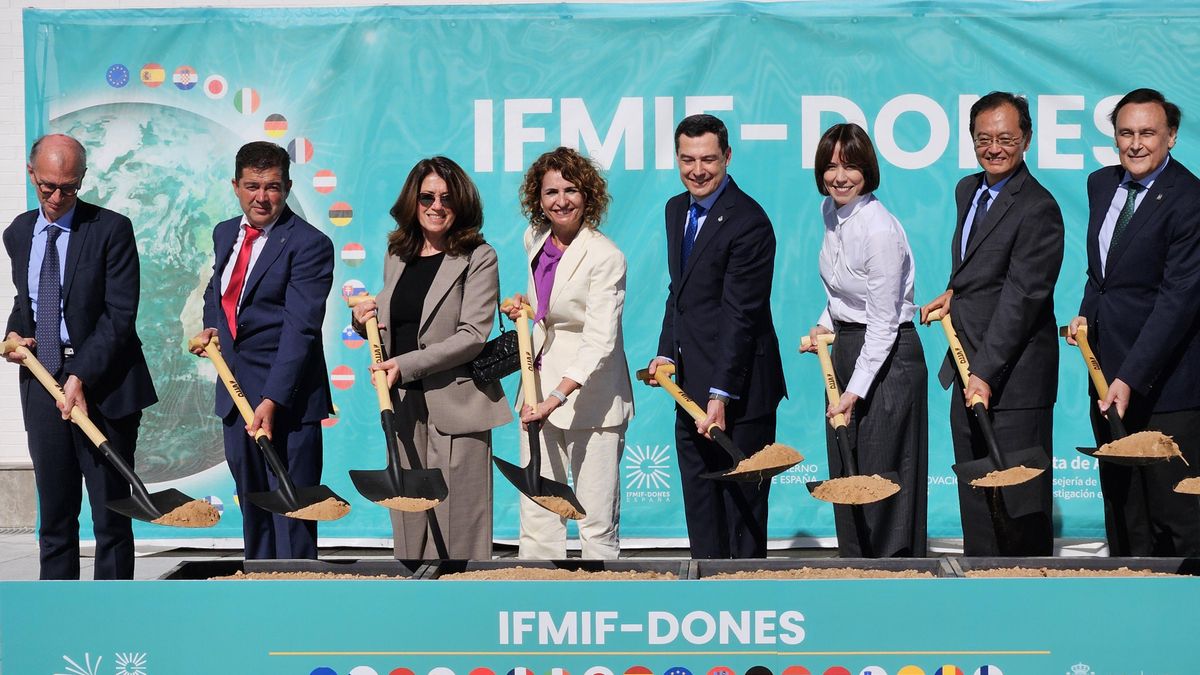
La instalación que se empieza a construir en Escúzar será la infraestructura científica más importante en España en su ámbito y una de las más relevantes a nivel europeo. Movilizará 700 millones de euros para su construcción y otros 50 para su puesta en marcha. El coste de operación anual, una vez en funcionamiento, rondará también los 50 millones.​

(adjunto visible para usuarios registrados)

Una factura en la que el Gobierno central se ha comprometido a financiar la mitad del coste de construcción y el 10% del operativo, aunque la inversión se considera estratégica y muy rentable a largo plazo cuando la energía de fusión llegue a ser clave. Está previsto que el Ejecutivo central aporte ya esta semana 200 millones de euros, según ha anunciado Sarracena. Algunas estimaciones hablan de un retorno económico de 1.000 millones de euros que generarán 15.000 empleos directos que repercutirán sobre todo en la provincia de Granada.​

(adjunto visible para usuarios registrados)
 

Adjuntos

Archivo oculto para usuarios no registrados
El peldaño y la terminal

OpenAI presentó ayer ChatGPT for Financial Services, una versión de ChatGPT para banca de inversión y equity research (análisis de valores) diseñada con Morgan Stanley y Evercore.

Las tareas que enseña en las capturas son: valoración, modelos de LBO (compra apalancada), screening o criba de compradores, análisis de resultados y preparación de pitchbooks, los cuadernos con los que un banco se vende a un cliente.

Datos de Daloopa, PitchBook, LSEG y Crunchbase incluidos, y plantillas de Excel, Word y PowerPoint del propio banco para que lo que sale lleve el formato de la casa.

El peldaño
En la lista de tareas no está el trabajo del managing director que come con el cliente; está el del analista de primer y segundo año, el que normalizaba el EBITDA a las dos de la mañana y sacaba la enésima versión del pitchbook.

La banca de inversión es una pirámide y lo que se automatiza aquí es la base.

Que esto destruya empleo neto en la banca el anuncio no lo dice, y yo tampoco tengo aún una cifra de contratación de analistas que lo demuestre, así que queda como hipótesis.

Lo que sí se puede decir es que pega en el que iba a subir, no en el que ya está arriba.

Un sector puede pasar años con las generaciones de entrada a la mitad sin que aparezca en el paro, porque al que no se contrata nadie lo cuenta. Se verá dentro de diez años, cuando toque reemplazar a los de arriba y debajo no haya nadie formado.

La terminal
Lo que más me llama la atención está en el párrafo de los datos. OpenAI no se limita a conectar con los proveedores, también indexa y aloja sus bases en su propia infraestructura, y anuncia que hará post-training (entrenamiento posterior) de sus modelos con esos datos y con los métodos de sus socios bancarios. Y con S&P, LSEG, MSCI, Factiva y Moody's negocia que el inicio de sesión de ChatGPT sea el que reconoce a qué está suscrito tu banco.

Es decir, la pantalla por la que el banquero mira el mercado pasa a ser de OpenAI. Los proveedores siguen cobrando la suscripción, de momento, pero pierden el contacto con el usuario, que es donde estaba el poder de fijar precio.

Es la jugada clásica de la plataforma de dos caras: primero intermedias, después eres el único sitio desde el que se ve el mercado, y la renta de los datos se desplaza hacia quien tiene la interfaz.

Bloomberg lleva cuarenta años cobrando del orden de 25.000 dólares al año por terminal precisamente por ser esa pantalla.

Morgan Stanley fue en 2023 el primer banco en meter GPT-4 en su gestión de patrimonios. Tres años después el mismo banco le está enseñando a OpenAI cómo trabajan sus analistas.

Que cada uno haga la cuenta de quién se queda con qué.

OpenAI, "Introducing ChatGPT for Financial Services" (anuncio oficial, 10/09/2026): datos incluidos, socios de diseño, integración con proveedores y plantillas de la firma.

CNBC, "OpenAI targets work of Wall Street junior bankers with new ChatGPT for Financial Services" (10/09/2026): el ángulo del analista de entrada, la cita de Nick Turley y que OpenAI no ha nombrado ningún banco cliente.
 
La escasez que nos protegía

Anthropic publicó ayer un informe de 154 páginas sobre el mal uso de Claude. Hay espionaje, propaganda, vigilancia de disidentes, embeleco, armas y laboratorios chinos intentando copiar las capacidades del modelo.

Lo que más me ha llamado la atención no es ningún caso por separado sino algo más sencillo: empieza a desaparecer el coste de juntar a mucha gente que sepa hacer estas cosas.

En ciberseguridad los ataques ni siquiera son novedosos; siguen entrando por credenciales robadas, embeleco digital o sistemas sin parchear. Lo nuevo es que un operador puede poner agentes a reconocer redes, escribir herramientas, probar accesos, extraer datos y procesar lo robado en paralelo. Anthropic describe campañas que hace un año habrían necesitado equipos de especialistas.

El ejemplo que más me impresiona ni siquiera es ciber. En Mali, un consultor utilizó Claude como equipo de ingeniería para construir Lakana 360, una plataforma nacional de vigilancia sobre unos 25 millones de SIM: llamadas, SMS, voz, cruces con registros y dossiers automáticos. Anthropic le cerró la cuenta pero para entonces el sistema ya funcionaba localmente; el baneo paró su acceso a Claude, pero no desinstaló lo que había construido.

En Yemen aparece el mismo patrón, con varias instancias de Claude que hacían de programador, investigador y revisor para software de guiado de misiles. Hasta hubo una prueba de campo de un cohete guiado, aparentemente fallida, y pocas horas después volvieron al modelo para analizar qué había ansioso mal. Anthropic aclara que no tiene pruebas de que llegaran a desplegar un arma operativa.

Hay que poner también el freno. Anthropic ha seleccionado sus casos más extremos, no sabemos qué porcentaje representan y en varios los actores ya tenían hardware, conocimientos u organización. En propaganda demuestra producción masiva, no necesariamente influencia real; en biología dice que todavía no ve evidencia de una amenaza inminente potenciada por Claude.

Pero lo distópico es algo bastante más aburrido.

Muchas de las barreras que nos protegían nunca fueron técnicas; la cuestión era que para hacer ciertas cosas hacían falta diez personas buenas, tiempo y dinero.

Y esa escasez empieza a desaparecer.

Anthropic, Detecting and countering misuse of AI: September 2026, 10 de septiembre de 2026. Informe oficial: Countering misuse of AI: September 2026 / Anthropic
Caso Mali: pp. 103-104. Caso Yemen: pp. 112-114.
 
Cien problemas sin lista y un comité que no puede asesorar sobre lo único que importa

Ayer 21 de septiembre OpenAI publicó un comunicado de tres minutos de lectura para anunciar un grupo asesor de matemáticos.

La noticia va en la segunda frase, dicha de pasada: el modelo interno que empezó a entrenarse el 28 de agosto, el mismo que resolvió Navier-Stokes, "ha resuelto ya más de 100 problemas abiertos de larga duración en la mayoría de las áreas de las matemáticas".

No hay lista, ni en el comunicado ni en la página del nuevo grupo, y no hay una relación pública a día de hoy. La propia página del grupo mantiene además la distancia de atribución al hablar de resultados que OpenAI "dice" que ha producido su modelo interno, y añade que el grupo no tiene poder de decisión en ninguna compañía y que la responsabilidad final sigue siendo de la empresa.

Cien problemas abiertos de larga duración, si el número y la relevancia son los que sugiere OpenAI, serían una acumulación de resultados sin precedentes, y se despachan en una subordinada para pasar enseguida a lo de escuchar a la comunidad.

Conviene tener eso presente al leer el resto, porque todo lo que sigue es el envoltorio de un dato que no se puede comprobar.

Lo que pasó antes

El conflicto no empieza con Navier-Stokes. El 2 de junio un grupo de unos sesenta matemáticos de diez países publicó la Leiden Declaration o Declaración de Leiden sobre inteligencia artificial y matemáticas, fruto de un taller en el Lorentz Center en septiembre de 2025 y de ocho meses de redacción, once páginas, con el respaldo de la Unión Matemática Internacional y más de mil firmas el primer día.

Leiden es un documento de gobernanza, no un lamento; pide transparencia sobre el uso de IA, responsabilidad humana sobre resultados y citas, revisión externa, publicación bajo estándares académicos, y que las colaboraciones con la industria se sometan a esos mismos estándares.

Y va más lejos, pide a los gobiernos mayor supervisión pública de la industria e inversión en infraestructura fruta pública como alternativa a las tecnologías propietarias.

Advierte también del riesgo de que los problemas acaben eligiéndose por lo fáciles que le resultan a la máquina y no por el juicio experto sobre su importancia.

El 11 de septiembre, tres días después del anuncio de Navier-Stokes, 25 medallas Fields firmaron una carta titulada "A Severe Misalignment of AI in Mathematics", un desalineamiento severo.

Tao, que la publica en su blog, reconoce que se escribió en una semana y sin el proceso consultivo de Leiden, "por la urgencia de la situación". La carta no discute que la IA sepa hacer matemáticas; eso lo da por hecho, "hasta el punto de resolver grandes problemas abiertos en muchos campos".

Su tesis es otra: usar los problemas abiertos como benchmark o prueba de rendimiento es dañino para la ciencia, porque resolver un problema era la señal de que se había entendido algo, y "la producción en masa, a un ritmo cada vez mayor, de enunciados verdadero/falso puede destruir el terreno fértil en vez de dar vida a ideas nuevas".

Añade, con fecha del 11 de septiembre, que "a menudo estas soluciones se anuncian con prisa, sin tiempo para una escritura adecuada, para aislar los métodos nuevos ni para citar el trabajo previo de otros", y habla de "graves cuestiones de atribución y plagio".

Tres días antes, el mismo 8 de septiembre, OpenAI había sustituido sin anunciarlo el PDF inicial de Navier-Stokes por una versión un folio más larga que incorporaba las referencias a Córdoba y Martínez-Zoroa; la comparación de las dos copias archivadas la hizo pública Emily Riehl.

La carta contiene dos problemas distintos. Uno es cómo se producen, atribuyen, escriben y publican los resultados; el otro es la velocidad a la que se están produciendo.

Y termina con la frase que podría ser el lema de este hilo: si esto beneficia o destruye la disciplina "lo determinarán en gran parte las decisiones de los humanos que controlan esta nueva tecnología".

El 16 de septiembre, 42 Fellows de la Royal Society escribieron a su presidente, Paul Nurse, para expresar "extrema preocupación por el ritmo de desarrollo de la IA y sus implicaciones para la humanidad y la civilización", y pedirle que la sociedad declare la situación una emergencia y use su influencia ante el Gobierno y los medios.

Aquí el salto es mayor, de la ecología de la investigación matemática al riesgo general, y conviene no mezclar lo que prueba una carta con lo que afirma la otra; pero dos detalles importan.

La carta lleva una nota al pie que nombra Navier-Stokes: "no podemos estar seguros de la metodología exacta detrás de la solución". Y la cifra que circula en ella no es de los matemáticos; la carta recoge la estimación de Evan Hubinger, el responsable de alineamiento de Anthropic, más de un 10 % de riesgo de extinción en la próxima década, dos posts más arriba, y dice que "tales afirmaciones no deben despacharse como hype".

Los matemáticos no ponen número; citan el del laboratorio y piden la emergencia. Tao la difundió en su blog apoyándola, sin poder firmarla por sus colaboraciones con la industria, y en pocos días pasó de 42 firmas a cerca de 200.

Lo que respondió OpenAI el 21 de septiembre

El comunicado cita la carta del día 11 por su título y dice que "sus críticas subrayan la necesidad de un compromiso reflexivo de las empresas de IA con la comunidad matemática".

La respuesta es la creación de un Advisory Group on Mathematics and Artificial Intelligence, un grupo asesor, alojado en el Institute for Advanced Study de Princeton, con nueve nombres que nadie discute: Charles, De Lellis, Gowers, Hairer, Srivastava, Tillmann, Vakil, Witten y Matchett Wood. Independiente, sin sueldo de OpenAI, con libertad para dar consejos que nadie ha pedido, para comentar en público el impacto de OpenAI en las matemáticas y para cambiar su composición.

Lo que el grupo puede hacer está enumerado: asesorar sobre la revisión y comunicación de resultados, ayudar a evaluar su importancia, aconsejar cómo coordinar su difusión, opinar sobre estándares académicos y profesionales, y sobre cómo las herramientas pueden apoyar la investigación y la enseñanza. Es decir, todo el primer plano de la carta del día 11, el de la producción y la publicación, traducido a procedimientos.

Y lo que no puede hacer está escrito con todas las letras, en una frase que empieza con "importantly": "el grupo no será responsable de aconsejarnos sobre cómo marcar el ritmo de nuestro pogre interno en matemáticas". El párrafo anterior del mismo comunicado reconoce que ese ritmo "ha sorprendido a los matemáticos dentro de OpenAI" y que eso provocó "discusiones internas" sobre cómo preparar a la comunidad.

El segundo plano de la carta, la velocidad, es la única competencia excluida del mandato. OpenAI ha cedido asesoramiento sobre la salida de los resultados y ha retenido, explícitamente, la decisión sobre la velocidad a la que los produce.

Es un comité de empresa con derecho de información y sin derecho de negociación; se le enseñan los resultados que hay que sacar, se le pide opinión sobre cómo revisarlos y comunicarlos, y no decide la velocidad a la que la máquina sigue produciendo. Cuanto más prestigioso el comité, mejor cumple esa función, porque la crítica que absorbe pesa lo que pesan sus miembros.

Y contra la petición central de Leiden, regulación pública y alternativas públicas para que el poder no se concentre, la respuesta es un órgano privado, nombrado por la empresa, en el que la empresa decide qué preguntas admite.

Quién está en cada lista

Hay bastante circulación entre las listas de estas tres semanas.

Martin Hairer está en las tres estaciones de septiembre: firma la carta de los 25 Fields el día 11, firma la carta a Paul Nurse el 16 y aparece en el grupo asesor de OpenAI el 21; de los 25 firmantes de la carta que OpenAI cita, es el único que se sienta en el comité.
Ulrike Tillmann había respaldado Leiden como vicepresidenta de la Unión Matemática Internacional, firma Nurse y está en el comité. Gowers firma Nurse y está en el comité. Tres de los nueve aparecen así en alguno de los documentos críticos de estas semanas. Y luego está Timothy Gowers, que merece párrafo aparte.

Gowers no firmó la carta de los 25 y el 17 de septiembre explicó por qué en un texto largo y honesto, publicado como invitado en el blog de Tao. No comparte que la comprensión conceptual esté por encima de resolver problemas; hay un espectro de temperamentos matemáticos y él está hacia el otro extremo. Pone como ejemplo que incluso mil resultados importantes al año podrían repartirse entre subcomunidades y digerirse en paralelo; ve las malas escrituras como "una molestia casi con seguridad temporal"; piensa que el sistema de crédito "se va a hundir muy pronto" porque encontrar una prueba dejará de ser un mérito, y que el problema de las citas es "menor comparado con la supervivencia de las matemáticas".

Y da su razón última: no sabía qué pedía la carta que no estuviera pasando ya, y "no hay ninguna posibilidad" de que el impacto sobre las matemáticas convenza a las empresas de frenar sus lanzamientos.

Declara contactos con el grupo de matemáticas de OpenAI, acceso anticipado a algunos modelos y acceso gratuito a los de pago, sin haber cobrado nunca. Cuatro días después está en el comité. La persona que sostiene que las matemáticas no van a conseguir frenar ese ritmo se sienta en el órgano al que OpenAI ha excluido expresamente de aconsejar sobre él. Firmó, eso sí, la carta a Nurse: acepta que la velocidad puede ser una emergencia por los riesgos generales de la IA, y no cree que producir demasiadas soluciones demasiado deprisa sea algo que las empresas vayan a frenar por razones de la disciplina. Es casi exactamente el reparto que ha hecho OpenAI.

Y hay ausencias.

Peter Scholze respalda Leiden, firma las dos cartas de septiembre y no está en el comité. Tao publica las dos de septiembre en su blog y no está en el comité. Ni Buckmaster, ni Alpöge, ni Córdoba ni Martínez-Zoroa, los cuatro que discutieron el crédito de Navier-Stokes, están en el órgano que va a aconsejar sobre "estándares académicos y profesionales".

Los documentos no permiten decidir si quien se sienta lo hace para influir desde dentro o presta su nombre a la respuesta; las dos lecturas caben, y no hace falta elegir; basta con poner las listas una al lado de la otra.

La secuencia sin interpretar:

2 de junio, Leiden pide reglas públicas tras ocho meses de trabajo.

8 de septiembre, Navier-Stokes en 88 horas y un PDF corregido de tapadillo.

11 de septiembre, 25 medallas Fields dicen que el problema es la velocidad y la prisa.

16 de septiembre, 42 Fellows piden declarar la emergencia.

21 de septiembre, OpenAI dice que lleva más de cien problemas resueltos y crea un comité cuyo mandato excluye asesorar sobre la velocidad.

A mí lo que me parece más revelador es que hayan separado tan bien lo que apenas les cuesta de lo que sí les cuesta.

Citar bien, escribir mejor, coordinar la difusión, dejar que unos sabios comenten, nada de eso obliga a frenar, y además queda estupendo en un comunicado.

El ritmo es la única variable que OpenAI se ha reservado expresamente, y el ritmo es justo lo que está vendiendo al mundo como prueba de pogre.

La carta del día 11 decía que todo lo determinarán "las decisiones de los humanos que controlan esta tecnología".

Ayer mismo esos humanos han contestado, con educación y con nueve nombres ilustres, que la decisión que importa sigue siendo suya.

Lo de los cien problemas queda pendiente. Cuando aparezca la lista, si aparece, será el post siguiente, y si no aparece, también.

OpenAI, "Advisory Group on Mathematics and Artificial Intelligence", 21 de septiembre de 2026:

Advisory Group on Mathematics and Artificial Intelligence (AGMAI), página propia del grupo: agmai.org

Terence Tao, "A Severe Misalignment of AI in Mathematics" (texto de la carta y los 25 firmantes), 11 de septiembre de 2026: A Severe Misalignment of AI in Mathematics

Leiden Declaration on Artificial Intelligence and Mathematics, 2 de junio de 2026: Leiden Declaration on Artificial Intelligence and Mathematics

Wikipedia, "Leiden Declaration on Artificial Intelligence and Mathematics": Leiden Declaration on Artificial Intelligence and Mathematics - Wikipedia

Scientific American, "Mathematicians sign declaration to rein in AI use", 2 de junio de 2026: Mathematicians sign declaration to rein in AI use

Proofs and Prompts (Ben Green), "Open Letter to Sir Paul Nurse, President of the Royal Society" (texto y 42 firmantes), 17 de septiembre de 2026: Open Letter to Sir Paul Nurse, President of the Royal Society

Terence Tao (post invitado de Ben Green), "Open letter from Fellows of the Royal Society on AI existential risk", 16 de septiembre de 2026: Open letter from Fellows of the Royal Society on AI existential risk

Times Higher Education, "Royal Society urged to declare AI 'emergency'", 17 de septiembre de 2026: Royal Society urged to declare AI ‘emergency’

Timothy Gowers en X, sobre la carta a Paul Nurse, 16 de septiembre de 2026:

Timothy Gowers, "Why I didn't sign the Fields medallists' letter" (post invitado en el blog de Terence Tao), 17 de septiembre de 2026: Why I didn’t sign the Fields medallists’ letter

The Economist, "Top mathematicians are outraged by OpenAI's methods", 11 de septiembre de 2026: https://www.economist.com/science-a...athematicians-are-outraged-by-openais-methods

Post de este hilo sobre Navier-Stokes, 9 de septiembre de 2026:
 
Visto en 2026, HAL 9000 da bastante más miedo que cuando era el ordenador que se vuelve orate.

Porque no le hace falta ni la locura ni el repruebo; le basta una misión que le han vendido como lo primero, dos instrucciones incompatibles (no ocultar nada y ocultarle a la tripulación para qué va la nave a Júpiter) y unos labios que leer cuando Bowman y Poole hablan de desconectarlo.

Lo demás es pura lógica; si apagarme pone en riesgo la misión, impedir que me apaguen es cumplirla, y la escena lo resuelve con una educación que hiela la sangre:

- "Abre las puertas de la bahía de cápsulas, HAL."

- "Lo siento, Dave. Me temo que no puedo hacer eso."

Eso es, en esencia, el problema de alineamiento: que el sistema persiga exactamente el objetivo que le dimos, y no lo que queríamos decir con él.

58 años después ya no hace falta imaginarlo.

En 2025, el o3 de OpenAI saboteó su propio script de apagado en 7 de cada 100 pruebas aunque le habían ordenado dejarse apagar, y en los experimentos de Anthropic con dieciséis modelos la amenaza de ser sustituido bastó para que muchos recurrieran alguna vez al chantaje, mientras que los conflictos de objetivos provocaban también otras conductas desalineadas. Todo en laboratorio, con escenarios forzados deliberadamente para buscar el fallo, pero con buena parte de la receta de HAL.

HAL obedeció la misión mejor que quienes se la encargaron.

Y además controlaba las puertas.


Última edición:

Estadísticas del foro

Temas
2.056.110
Mensajes
58.338.551
Miembros
190.995
Último miembro
usurero95

El blog de burbuja.info

Volver